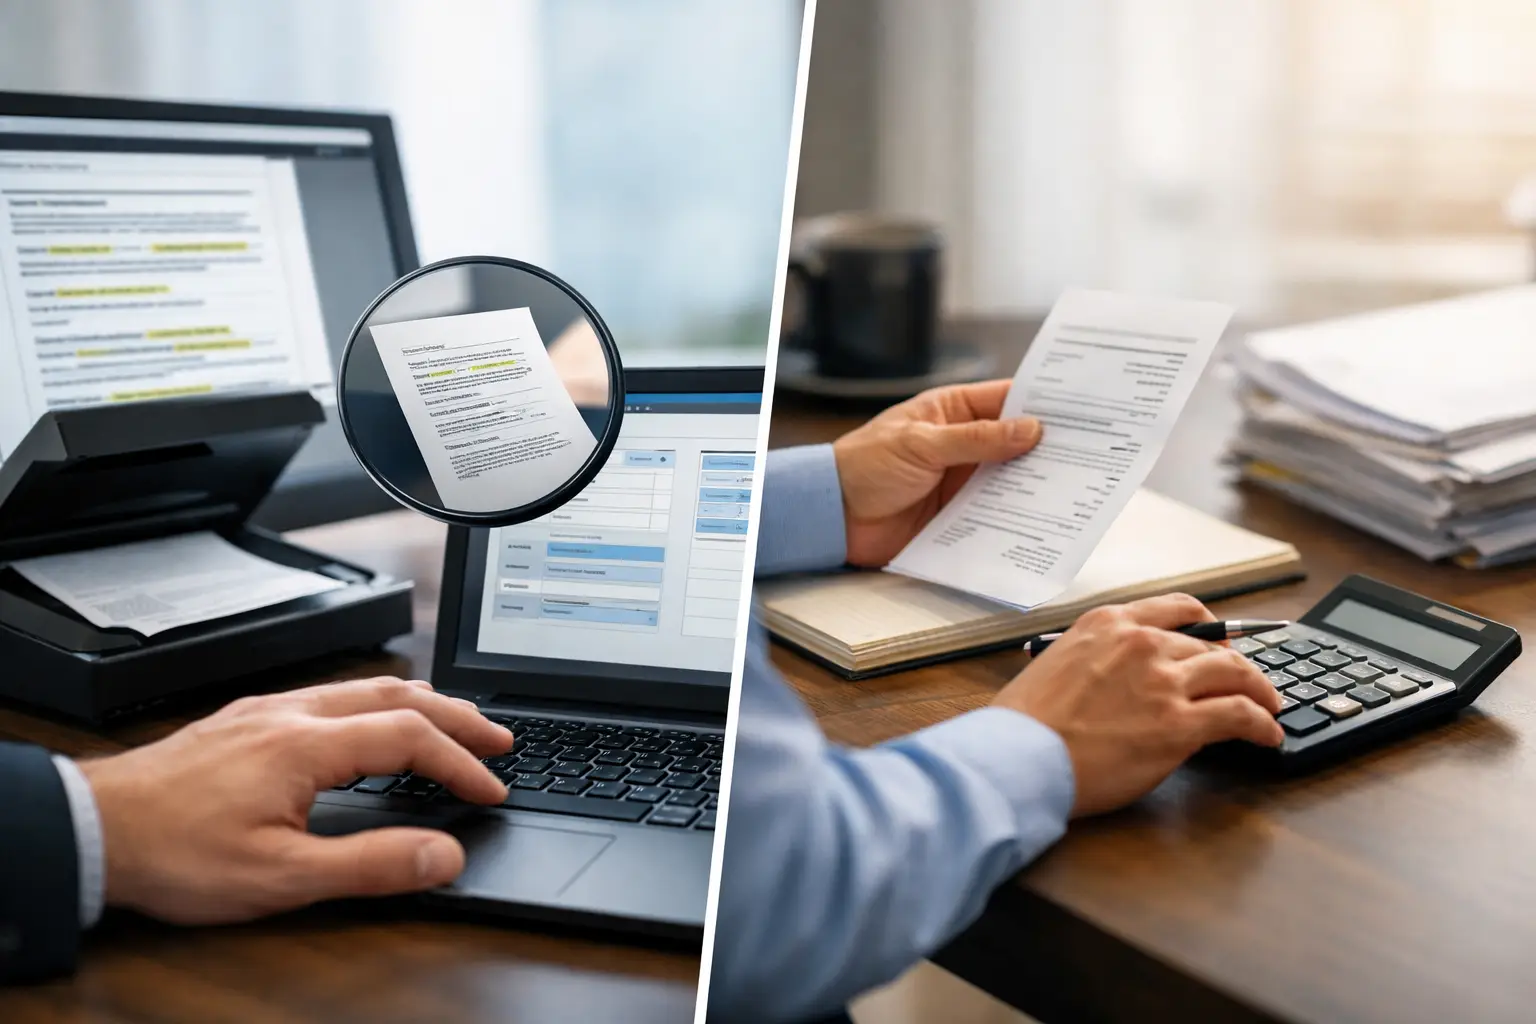



Un expediente de alta, una solicitud de crédito o un archivo escolar puede parecer un documento más hasta que exige localizar un dato, comprobar su origen o responder a una auditoría. En ese punto, la decisión entre OCR vs captura manual deja de ser tecnológica: afecta al coste operativo, al riesgo de error, a los tiempos de atención y a la capacidad de demostrar cumplimiento.
Para organizaciones con alto volumen documental, la cuestión no es si el equipo puede teclear información. Puede hacerlo. La cuestión es si ese modelo soporta el crecimiento, conserva evidencia verificable y entrega datos utilizables a los sistemas que gobiernan la operación.
OCR vs captura manual: la diferencia real
La captura manual consiste en que una persona lee un documento y transcribe campos a una aplicación, hoja de cálculo, ERP o CRM. Es un método conocido, flexible y aparentemente sencillo de activar. También depende de la disponibilidad, formación y consistencia de cada capturista.
El reconocimiento óptico de caracteres, u OCR, extrae texto impreso de una imagen o documento digitalizado. Cuando se combina con ICR para escritura manuscrita, modelos de IA, reglas de validación y clasificación documental, se convierte en una capacidad de Intelligent Document & Data Processing. No solo lee una factura, una identificación o un contrato: identifica su tipo, localiza los campos relevantes, contrasta reglas y prepara los datos para su integración.
La diferencia relevante no está en sustituir personas por software. Está en asignar a las personas las excepciones y decisiones que requieren criterio, mientras la plataforma procesa la parte repetitiva, medible y auditable del trabajo documental.
Cuándo la captura manual sigue teniendo sentido
La captura manual no debe descartarse por principio. Puede ser adecuada cuando el volumen es muy bajo, los documentos no siguen ningún patrón, la información requiere interpretación especializada o se trata de un proceso temporal sin previsión de crecimiento.
También resulta útil como mecanismo de revisión. Un dato extraído con baja confianza, un documento ilegible o una discrepancia entre fuentes necesita una intervención humana. El error habitual consiste en diseñar todo el proceso alrededor de esas excepciones, obligando a revisar manualmente incluso los documentos claros y repetitivos.
En operaciones críticas, el coste de la captura manual rara vez se limita al salario del equipo. Hay que considerar la doble revisión, los reprocesos, los expedientes incompletos, el retraso en altas, las consultas a otras áreas y el tiempo invertido en reconstruir quién modificó un registro. Si el proceso está vinculado a KYC, prevención de fraude, admisiones, nóminas o cumplimiento regulatorio, el impacto puede extenderse al riesgo reputacional y sancionador.
Dónde OCR aporta una ventaja operativa clara
OCR muestra su mayor valor cuando se reciben grandes lotes de documentos con estructuras similares o parcialmente previsibles. Pólizas, comprobantes, identificaciones, contratos, expedientes de empleados, solicitudes de clientes, certificados académicos y documentos administrativos son ejemplos frecuentes.
La automatización puede clasificar cada archivo, extraer campos como nombre, fecha, importe, CURP, RFC o número de contrato, y validar formatos y consistencia. Si el dato no cumple una regla, el sistema puede enviarlo a una bandeja de excepción con el documento y el campo señalado. Así, el equipo no busca errores a ciegas: atiende únicamente los casos que necesitan intervención.
La velocidad importa, pero no es el único beneficio. Un OCR empresarial conserva la relación entre el dato y su evidencia documental. Esto permite recuperar el expediente original, conocer la fecha de procesamiento, consultar las correcciones y mantener trazabilidad por usuario y etapa. Para áreas de cumplimiento, legal y auditoría, esa diferencia es determinante.
Precisión: el indicador que debe analizarse con contexto
Comparar precisión entre OCR y captura manual exige cuidado. Una persona puede interpretar documentos complejos mejor que un motor de reconocimiento, pero también puede cometer errores por fatiga, presión de tiempo, variaciones de criterio o duplicidad de tareas. El OCR puede extraer miles de campos de forma consistente, aunque su resultado depende de la calidad de imagen, el diseño documental, el idioma, la escritura manuscrita y el entrenamiento de los modelos.
Por eso, un proyecto serio no se mide solo por el porcentaje de caracteres reconocidos. Debe medir la precisión de los campos críticos, la tasa de documentos procesados sin intervención, el volumen de excepciones, el tiempo de resolución y el porcentaje de integraciones completadas correctamente.
En un onboarding financiero, por ejemplo, no basta con leer correctamente un nombre. Hay que comprobar que el documento corresponde a la persona, que los datos requeridos están completos y que el expediente puede avanzar bajo las reglas internas y regulatorias aplicables. La extracción es el inicio del flujo, no el final.
El coste por documento cambia al escalar
La captura manual suele parecer más económica al inicio porque no requiere configuración, integración ni definición de reglas. Sin embargo, su coste crece casi de forma proporcional al volumen. Más documentos implican más horas, más supervisión y, normalmente, más variación en la calidad.
OCR requiere una fase inicial de análisis: tipologías documentales, campos a extraer, criterios de confianza, políticas de excepción, seguridad e integración. Esa inversión cobra sentido cuando reduce tareas repetitivas y permite absorber picos de demanda sin ampliar la plantilla al mismo ritmo.
La evaluación debe incluir el coste total de operación. Conviene comparar el tiempo desde recepción hasta disponibilidad del dato, la carga de revisión, el número de errores detectados después del registro, el coste de atender auditorías y la capacidad de integrar la información con los sistemas existentes. Si los datos terminan aislados en una carpeta o en una hoja de cálculo, la digitalización no ha resuelto el problema de negocio.
Integración y cumplimiento: el criterio decisivo
En sectores regulados, OCR no puede evaluarse como una herramienta aislada. Debe integrarse con el ECM, BPM, ERP, CRM, repositorio documental o data lake que utiliza la organización. La arquitectura debe definir qué sistema conserva el documento original, dónde reside el dato estructurado, quién puede acceder a cada elemento y cómo se registra cada acción.
Este enfoque es especialmente relevante en procesos de identificación y cumplimiento. Una integración mediante API puede activar validaciones, consultas, alertas y flujos de aprobación sin obligar a los equipos a cambiar de aplicación entre pasos. Cuando el caso requiere integración con la Plataforma Única de Identidad, la gestión de evidencias, controles de acceso y autonomía de la base de datos del cliente no son detalles técnicos: forman parte del cumplimiento.
La ciberseguridad también debe estar presente desde el diseño. Cifrado, autenticación, perfiles de acceso, registros de actividad, retención documental y pruebas de integración son requisitos operativos. Automatizar una mala práctica solo acelera el riesgo.
Cómo decidir entre OCR y captura manual
La decisión correcta rara vez es absoluta. En la práctica, los mejores resultados proceden de un modelo híbrido: OCR e IA procesan documentos y campos previsibles; reglas de negocio validan lo extraído; y los equipos revisan excepciones, casos ambiguos y decisiones de mayor impacto.
Antes de elegir, conviene responder a cuatro preguntas. ¿Cuántos documentos entran cada mes y cuánto varía ese volumen? ¿Qué campos son críticos para facturar, dar de alta, cumplir o atender a un cliente? ¿Qué errores se detectan tarde y cuánto cuesta corregirlos? ¿A qué sistemas debe llegar el dato sin intervención adicional?
Si la respuesta incluye miles de documentos, datos repetitivos, plazos exigentes, auditorías frecuentes o integraciones críticas, OCR con automatización documental suele ofrecer una ventaja clara. Si el proceso es esporádico, poco estructurado y de bajo riesgo, la captura manual puede seguir siendo una opción razonable, siempre que se controle y documente.
Apoint México trabaja esta decisión desde el proceso, no desde una promesa genérica de automatización. Con más de 10 millones de documentos procesados mensualmente mediante OCR e IA, el foco está en convertir documentos en datos trazables y datos en inteligencia operativa para cumplimiento y operación.
El objetivo no es eliminar la intervención humana. Es evitar que el talento especializado dedique su jornada a transcribir información que ya existe en el documento, mientras los procesos críticos esperan una respuesta.